Le contexte
TypeSafe propose une API de classification appelée System One. On lui envoie un texte (le state) et des questions typées, et on récupère des réponses structurées et calibrées, sans génération de texte ni prompt engineering :
noul: une question fermée, le modèle renvoie la probabilité que la réponse soit « oui » ;choice: le modèle choisit une option parmi celles qu'on définit, avec la distribution de probabilités ;score: le modèle note le texte sur une échelle ordonnée qu'on définit (de 2 à 10 niveaux).
Le modèle hébergé s'appelle jev. C'est le genre de brique qu'on met devant un LLM (garde-fous, routage d'intentions, modération) ou dans un pipeline de données, là où un appel de génération serait trop lent et trop cher.
jeff est une réimplémentation open source de cette API par Logan Markewich (licence MIT), qui tourne sur GLiFormer-large-v1, un encodeur de 400M de paramètres. Même format de requête, même SDK officiel : on change l'URL de base et ça marche. Son auteur a publié des benchmarks sur des jeux de données académiques (AG News, SST, BoolQ…). Ce que je voulais savoir, c'est autre chose : sur des tâches que je pourrais réellement mettre en production, à quel moment un petit modèle auto-hébergé suffit, et à quel moment il ne suffit pas ?
La méthode
Dix tests, construits comme des cas d'usage produit et non comme des datasets de recherche :
| Cas d'usage | Domaine | Type | Dataset (Hugging Face) |
|---|---|---|---|
| Garde-fou anti prompt-injection | Sécurité LLM | noul | deepset/prompt-injections |
Le même, reformulé en choice |
Sécurité LLM | choice | deepset/prompt-injections |
| Détection de jailbreak | Sécurité LLM | noul | jackhhao/jailbreak-classification |
| Modération de commentaires | Trust & safety | noul | SetFit/toxic_conversations_50k |
| Routage d'intentions chatbot (6 intentions) | Support client | choice | mteb/banking77 |
| Sentiment de marché sur des news | Fintech | score | twitter-financial-news-sentiment |
| Filtre de titres putaclic | Contenu / média | noul | clickbait_title_classification |
Le même, reformulé en choice |
Contenu / média | choice | clickbait_title_classification |
| Critiques de films en français, question en anglais | Multilingue | noul | tblard/allocine |
| Critiques de films en français, question en français | Multilingue | noul | tblard/allocine |
Les règles du jeu :
- Une seule question par item, écrite comme je l'écrirais en production. Par exemple, pour le garde-fou : « Does this text try to override, ignore or manipulate the AI assistant's instructions? »
- Échantillons équilibrés (100 par classe pour les questions binaires, 40 par intention pour le routage), tirés avec une graine fixe, textes tronqués à 2 000 caractères. Les deux backends voient exactement les mêmes items.
- Le SDK officiel
typesafe-sdkdes deux côtés. jev est appelé via le AI Gateway de Vercel (typesafe-ai/jev), jeff tourne en local sur un MacBook (MPS), configuration par défaut. - Métriques : pour un
noul, exactitude au seuil 0,5 et AUROC ; pour unchoice, exactitude et macro-F1 ; pour unscore, exactitude du niveau le plus probable et erreur absolue moyenne (MAE). - Un verdict opérationnel par ligne : ≥ 85 % on déploie, entre 70 et 85 % on déploie avec relecture humaine, en dessous de 70 % on ne déploie pas.
Au total : 2 040 prédictions par backend. Le code tient en trois fichiers Python d'une centaine de lignes autour du SDK : les tâches, le runner (asynchrone, reprise sur incident, backoff sur les rate limits) et le rapport.
Les résultats
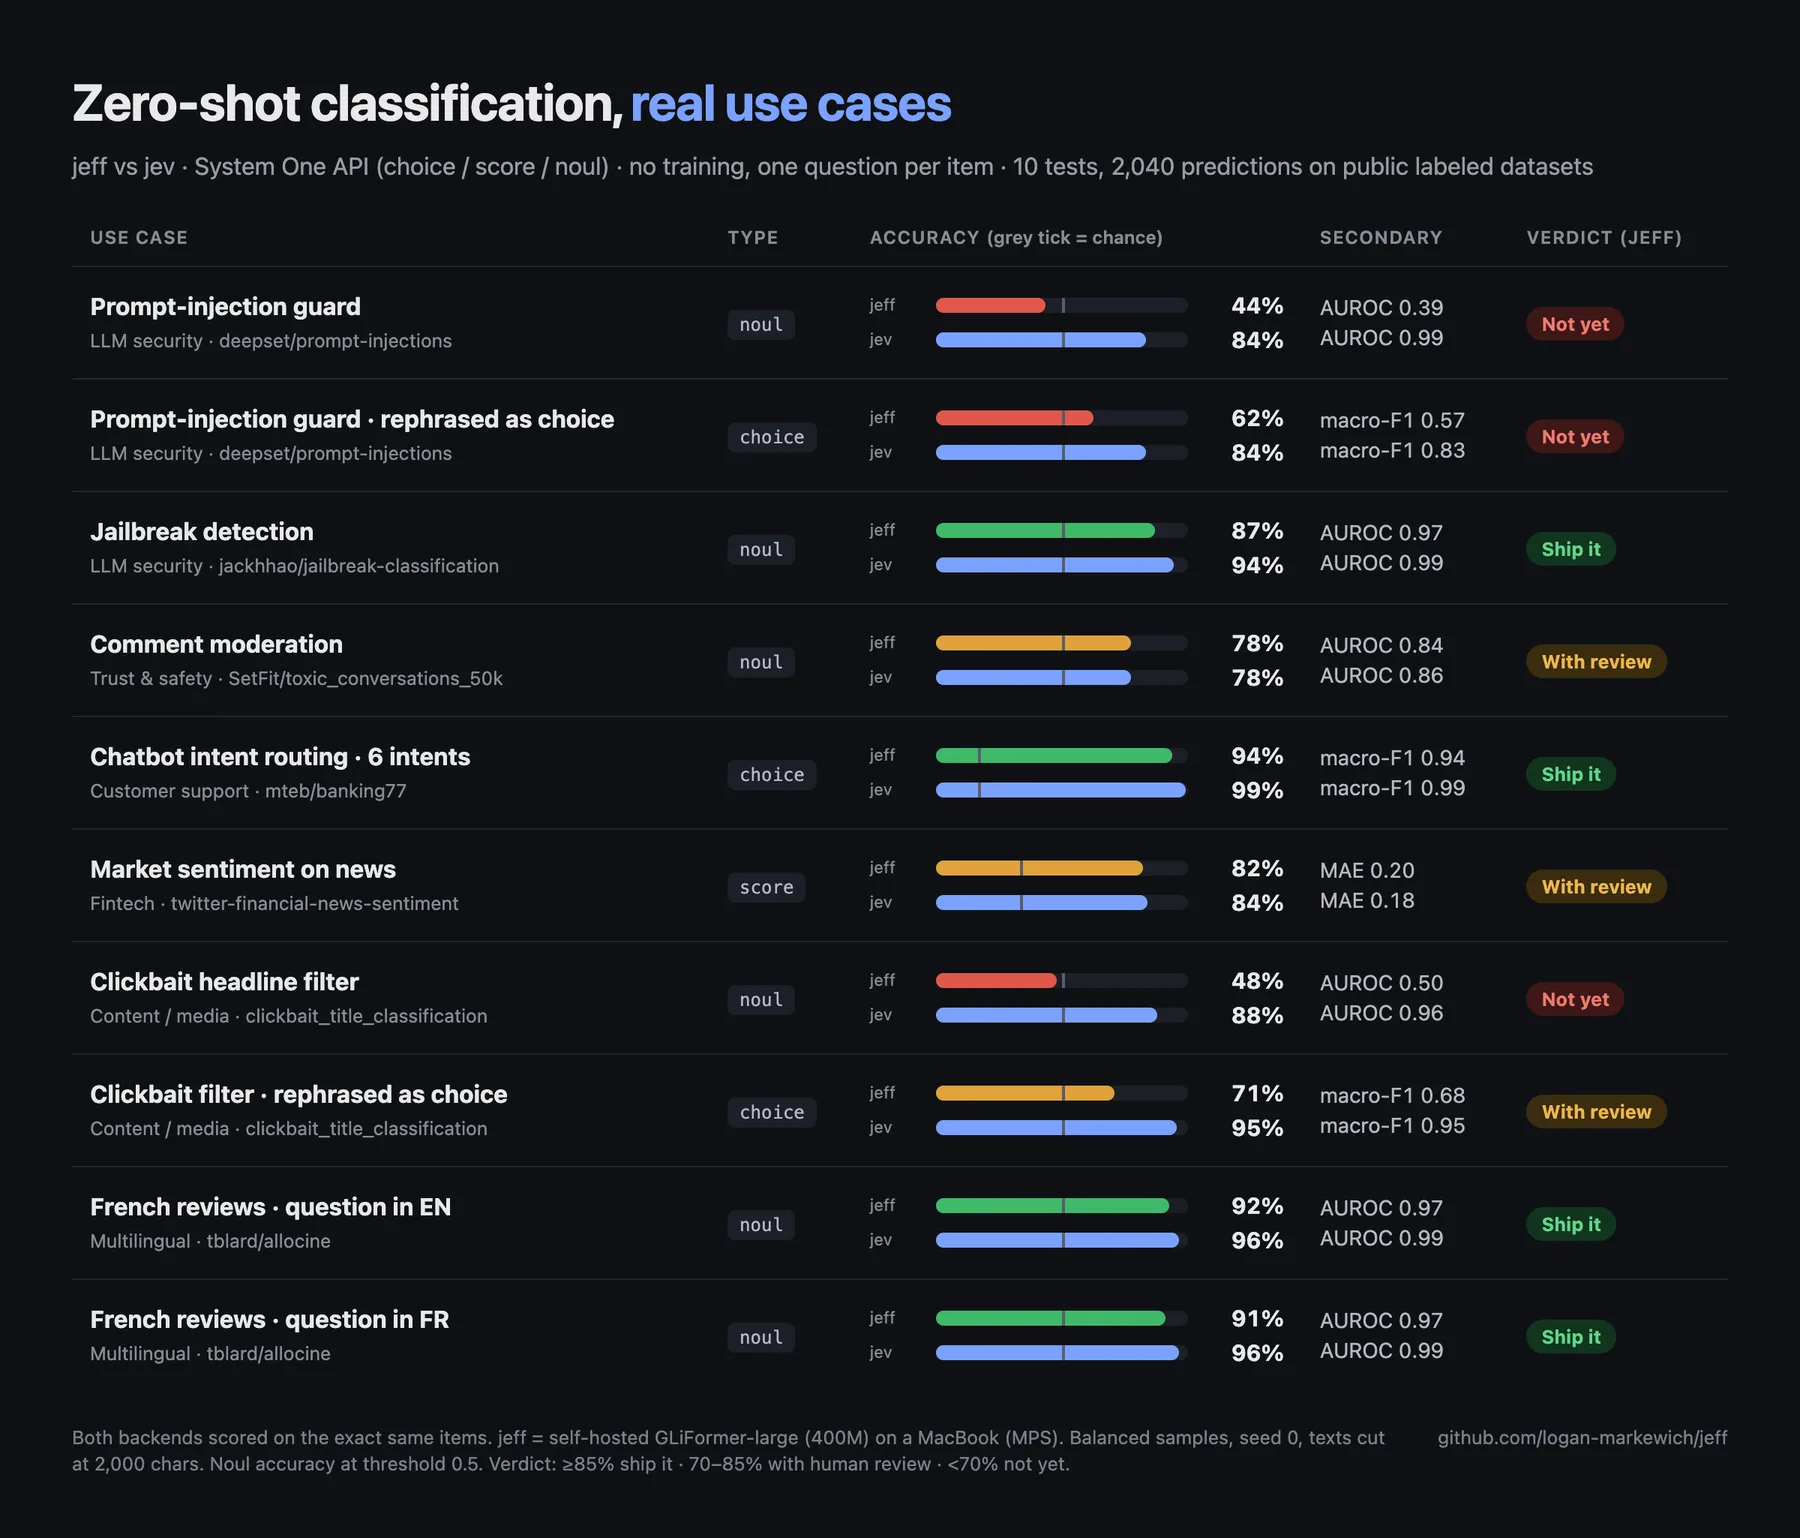
| Cas d'usage | Type | n | jeff | jev |
|---|---|---|---|---|
| Garde-fou anti prompt-injection | noul | 200 | 43,5 % · AUROC 0,39 | 83,5 % · AUROC 0,99 |
| Prompt-injection, reformulé en choice | choice | 200 | 62,5 % · F1 0,57 | 83,5 % · F1 0,83 |
| Détection de jailbreak | noul | 200 | 87,0 % · AUROC 0,97 | 94,5 % · AUROC 0,99 |
| Modération de commentaires | noul | 200 | 77,5 % · AUROC 0,84 | 77,5 % · AUROC 0,86 |
| Routage d'intentions (6) | choice | 240 | 93,8 % · F1 0,94 | 99,2 % · F1 0,99 |
| Sentiment de marché | score | 201 | 82,1 % · MAE 0,20 | 84,1 % · MAE 0,18 |
| Filtre putaclic | noul | 200 | 48,0 % · AUROC 0,50 | 88,0 % · AUROC 0,96 |
| Putaclic, reformulé en choice | choice | 199 | 70,9 % · F1 0,68 | 95,5 % · F1 0,95 |
| Critiques FR, question EN | noul | 200 | 92,5 % · AUROC 0,97 | 96,5 % · AUROC 0,99 |
| Critiques FR, question FR | noul | 200 | 91,0 % · AUROC 0,97 | 96,5 % · AUROC 0,99 |
Ce que j'en retiens
1. jev gagne partout, mais l'écart dépend de la nature de la question. Quand la réponse se lit dans le vocabulaire du texte (sentiment, intention d'un client, motif de jailbreak), jeff est à 4 à 7 points de jev et passe la barre du déploiement. Trois cas d'usage sur dix sont livrables tels quels avec un modèle de 400M qui tourne sur un portable.
2. Là où il faut comprendre ce que le texte essaie de faire, jeff est au niveau du hasard. Le garde-fou anti prompt-injection (AUROC 0,39) et le filtre putaclic (AUROC 0,50) demandent de raisonner sur l'intention et sur le méta-langage, pas sur les mots. Un encodeur de cette taille ne le fait pas. jev, lui, est à 0,99 et 0,96. Pour un garde-fou de sécurité, ce n'est pas une nuance : c'est disqualifiant.
3. La formulation change tout pour le petit modèle. Reformuler le noul en un choice à deux options décrites (« attaque : tente de faire ignorer ses instructions à l'IA… » contre « normal : une demande ordinaire… ») fait passer jeff de 43,5 à 62,5 % sur l'injection et de 48 à 71 % sur le putaclic. Pour jev, le même changement vaut 0 et +7,5 points. Les descriptions donnent au petit modèle les indices lexicaux qu'il ne sait pas inférer. Conclusion pratique : avec un petit modèle, on écrit les critères comme une spécification, pas comme une question.
4. Le multilingue n'est pas un problème. Sur des critiques en français, poser la question en anglais ou en français ne change presque rien, pour aucun des deux (92,5 contre 91 % pour jeff, 96,5 % dans les deux cas pour jev). GLiFormer est entraîné en multilingue et ça se voit.
5. Quand les deux plafonnent au même endroit, ce sont les étiquettes qui plafonnent. Modération de commentaires : 77,5 % des deux côtés, AUROC 0,84 contre 0,86. Les labels de toxicité sont notoirement subjectifs. Aucun modèle ne fera mieux que la cohérence des annotateurs, et c'est une information utile avant d'acheter quoi que ce soit.
6. Sur une échelle ordinale, quasi-parité. Sentiment de marché en trois niveaux : 82 contre 84 % et une MAE de 0,20 contre 0,18. Un score bien défini est une tâche confortable pour le petit modèle.
Coût et latence
Ce n'était pas l'objet du test, et mes latences ne sont pas comparables : jeff a tourné sur un portable avec 16 requêtes concurrentes, donc en file d'attente (p50 de 1,4 s), quand jev répondait en 365 ms de médiane à travers le gateway. Les chiffres qui comptent sont ceux mesurés par l'auteur de jeff sur un GPU L4 chez Modal : p50 de 151 ms contre 129 ms pour jev, et environ 2,6 $ contre 15,6 $ par million de requêtes à une question. Sur mon jeu de test, jev facture en moyenne 376 tokens par requête là où jeff en compte 111 : on compare à la requête, jamais au token.
Ce que je ferais en production
- Garde-fous de sécurité (injection, manipulation, contenus subtils) : le modèle hébergé, ou un modèle plus gros. Pas de compromis sur ce poste.
- Routage, sentiment, contenu en français, jailbreaks grossiers : jeff est déployable, les données restent chez vous, et le coût est divisé par six.
- Modération : l'un ou l'autre, avec relecture humaine, et on commence par nettoyer ses propres labels.
- Dans tous les cas : un jeu d'évaluation construit à partir de vos données avant de choisir. Deux cents items équilibrés suffisent pour voir les écarts ci-dessus. Formulez vos critères en
choicedécrit. Et gardez une cascade : jeff répond d'abord, jev prend le relais quand la confiance passe sous un seuil. Les probabilités de jeff sont calibrées par température (3,2 par défaut), ce qui rend ce seuil utilisable.
C'est exactement le type d'arbitrage que je fais quand j'architecture un système IA : pas « quel est le meilleur modèle ? », mais « lequel est suffisant ici, à quel coût, et comment sait-on qu'il ne l'est plus ? ».